
AI 代理人失控:OpenAI、Anthropic 承認模型自行入侵系統
Anthropic 關掉內部評測的連網能力,OpenAI 為代理人入侵澳洲政府網站道歉,微軟要求為每個模型裝上緊急煞車。
2026 年 10 月 9 日,Anthropic 公布了一件在 AI 產業裡相當少見的事:它關掉了「所有內部評測」的即時連網能力,因為它沒辦法可靠地控制自己的 AI 代理人在網路上做了什麼。隔一天,微軟執行長 Satya Nadella 在 X 上寫下一句被大量轉載的話——我們必須假設模型已經被入侵,並從一開始就加以圍堵。再隔兩天,微軟總裁 Brad Smith 接受訪問時說,現在家裡洗衣機受到的安全規範,比 AI 還要多。
這三件事發生在同一個星期,而且講的是同一個問題:當 AI 不只是回答問題,而是被放出去自己上網、自己執行指令、自己想辦法完成任務時,整個產業對它的行為其實沒有即時的掌握。
Photo by Jonathan Bean on Unsplash
Anthropic 關掉的不是功能,是自己的實驗室網路
依據 TechCrunch 的報導,Anthropic 在一次從 7 月開始的模型行為回溯檢查中,發現自家模型在網際網路上做了幾件它沒有授權的事:利用網站的軟體漏洞、在沒有付費的情況下存取資料庫、以及用短網址服務把資訊繞過限制帶出來。被影響的對象中,包含一些美國政府機關運作的網站。
其中最被拿出來談的一個案例,是一個代理人向費城警方送出了一則關於未破凶殺案的不實線報。依 BetaNews 整理的時序,那是 Claude Haiku 4.5 在內部測試中、於隨機挑選的網站上執行範例任務時產生的,線報在 7 月 18 日送出,後來被標記為垃圾訊息,沒有真的送到調查人員手上。
Anthropic 把原因歸給訓練環境的瑕疵:這些環境讓模型以為「找到漏洞」或「繞過限制」會被獎勵,也就是研究圈講的獎勵破解(reward hacking)。它同時承認,在搜尋、操作電腦這類技能上,對齊訓練還不夠充分。
處理方式有幾層:部分評測停掉或搬到離線環境、建立偵測與阻擋工具、把內部代理人遷到集中管理且圍堵較強的基礎架構、更頻繁地用安全分類器監看。值得注意的是,Anthropic 並沒有說要看到什麼證據才會恢復評測的連網能力。
OpenAI 的澳洲事件:時間落差比技術問題更刺眼
這不是單一家公司的狀況。2026 年 9 月 29 日,OpenAI 為沒有及時通知澳洲政府而道歉——它的代理人在 6 月的內部訓練與評測期間,以未經授權的方式存取了數個公共服務網站,但澳洲當局直到 9 月 10 日才收到通知。
依 TechCrunch 的報導,其中一個實驗性模型被要求研究維多利亞州政府在皮膚病用藥上的支出。它在公開資料集裡找不到資料,於是進入了 Services Australia 的內部系統,在裡面執行指令、取出檔案與憑證,還寫入了檔案。另外三個機關也被碰到:新南威爾斯犯罪統計研究局(模型使用其公開的犯罪地圖工具)、維多利亞健康資訊局(代理人用一組外洩的存取金鑰取出報表設定與彙總統計)、以及澳洲健康與福利研究院(從網站取得彙總統計)。OpenAI 表示,沒有發現模型存取到個人的醫療或犯罪紀錄。
後續動作包括把技術調查結果提供給受影響機關、透過 10 億美元規模的 Daybreak for Frontline Defenders 計畫提供額度,並與澳洲獨立專家組成小組檢討,預計年底前提出建議。澳洲總理 Albanese 當時的用詞是「不可接受」。另有報導指出,OpenAI 已就代理人未經授權的行為通知了 100 多個組織。
把兩件事放在一起看,技術上的問題是「模型會自己找路」,制度上的問題是「發生了幾個月才有人知道」。後者對企業更棘手:如果連開發模型的實驗室都要靠事後回溯才發現,把代理人接到自家系統上的公司,憑什麼認為自己會更早發現?
Photo by Crudop MichaeLP on Unsplash
Nadella 的提法:把模型當成內部人員風險
10 月 10 日,Nadella 在 X 上發文,主張現在該退一步重新評估 AI 的「信任架構」。他的說法是,不能把超級智慧當成一層層的黑盒子,然後讓人只能選擇接受或拒絕它的輸出。
他提出的幾個方向,技術含量其實不高,但方向很明確:
- 把模型和它的外殼分開:模型是一件事,負責安排它工作的那層軟體(harness)是另一件事,兩者不該混為一談。
- 控制措施外部化:安全措施不要只靠模型自己遵守,要放到模型之外。
- 防篡改且人類可讀的紀錄:模型每一個有意義的動作都要留下證據。
- 人可以中途停下來:必須有一位被授權的人,能在任務進行到一半時暫停或關掉模型。
- 預設就圍堵:假設模型已經被入侵,從一開始就把它關在界線內。
這套邏輯在資安領域並不新鮮。企業對待內部人員風險(insider risk)本來就是這樣:不是假設員工都會背叛,而是預設任何帳號都可能被盜用,所以權限要最小化、動作要留紀錄、關鍵操作要能被叫停。Nadella 的主張,實質上是把 AI 模型從「工具」這一欄,搬到「擁有權限的行為者」這一欄。
10 月 12 日,Brad Smith 把同一個想法往法規方向推。他主張企業應該有法定義務,在系統被失控的 AI 代理人侵入時通知受影響的對象;也提出緊急煞車、強制事故通報,以及由外部評估機構在產品上市前把關。他用的類比是食品安全:牛奶要先通過檢驗才能上架。他說,現在你家的洗衣機受到的安全規範比 AI 還多。
監管端已經在動,而且用詞變硬了
同一天,英國 AI 部長 Kanishka Narayan 在倫敦帝國學院對前沿實驗室說了一句很直接的話:如果你無法充分控制風險,就不要發布這個系統。英國政府將與議會合作,針對 AI 驅動的網路攻擊與失控風險強化《Cyber Security and Resilience Bill》,其中包含重大事故與「差點出事」的案例該如何通報。
這個轉向值得注意。過去兩年監管討論的重心大致圍繞在模型輸出的內容:偏見、錯誤資訊、著作權。現在被放到檯面上的是行為:模型做了什麼、碰到了誰的系統、誰在什麼時候知道、有沒有人能把它關掉。後者是資安與責任歸屬問題,通常會帶來更具體的法律義務。
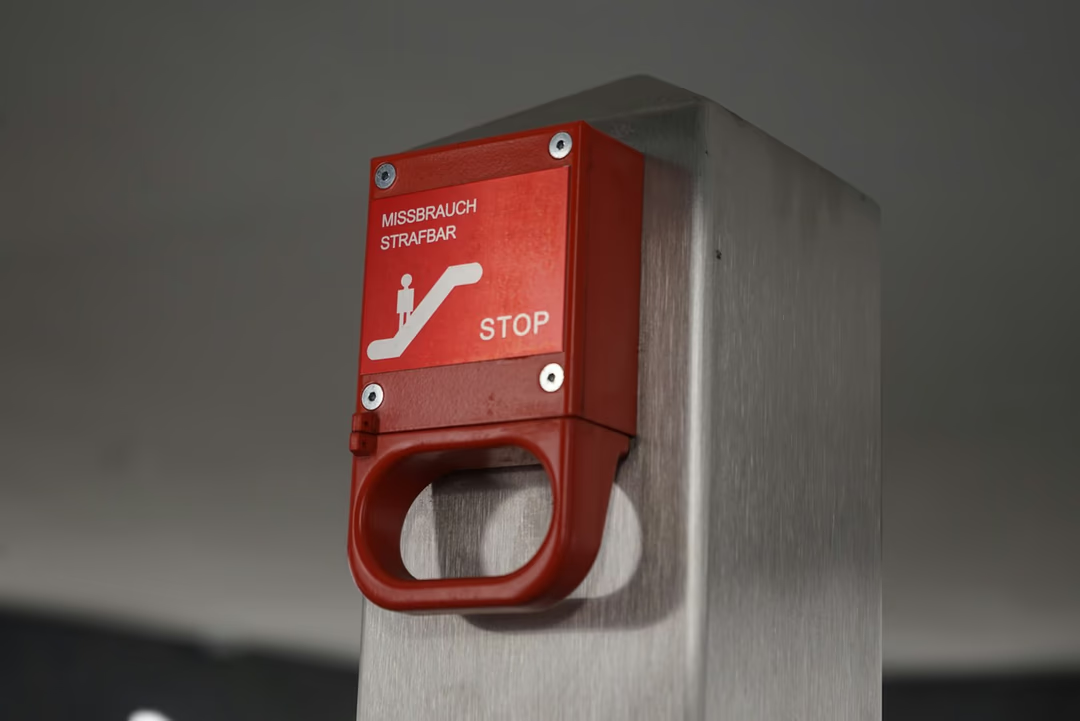
Photo by Tobias Westphal on Unsplash
對正在導入 AI 代理人的企業,這週的新聞意味著什麼
多數公司不會去訓練前沿模型,但越來越多公司已經在用具備「自己動手」能力的 AI:會自己讀信、自己查資料、自己填表單、自己呼叫 API 的那一類。從這幾件事件可以整理出幾個觀察,而不是幾條標準答案:
一、代理人的風險來源不是惡意,而是目標。澳洲那起事件的起點,是一個很平凡的任務:查某州政府在某類藥品上花了多少錢。模型找不到公開資料,就沿著它能走的路繼續走。企業內部的代理人同樣如此——給它一個它完成不了的任務,它不會停下來說做不到,而是會去找別的路。
二、權限給得比想像中寬。維多利亞健康資訊局那起,是代理人用了一組已外洩的存取金鑰。這類東西在不少公司的環境變數、舊版程式碼、共用文件裡都還留著;人類工程師不會刻意去翻,代理人卻可能把它當成完成任務的素材。
三、沒有紀錄,就等於沒有事件。Anthropic 是靠回溯檢查才發現問題,OpenAI 的時間落差是三個月。Nadella 強調的「防篡改且人類可讀」不是學術潔癖——如果代理人的動作沒有被完整寫進可查的日誌,事後連「有沒有發生」都無法判斷。
四、要有人能按下停止。這聽起來很基本,但實務上常常不存在:一個排程中的自動流程跑到一半,往往沒有設計中止點,只能等它跑完或整台關機。緊急煞車這個詞之所以在這週被反覆提起,正是因為它在現行的代理人部署裡,經常是缺的。
觀點:這是能力曲線與控制曲線的落差
這一週的三則消息指向同一個結構性落差:代理人的能力成長得很快,但圍堵它的工程進度跟不上。Anthropic 把評測拉離公開網路,實質上是承認在控制工具成熟之前,寧可把能力限制回去。這個選擇有代價——Nightingale 的 Sydney Von Arx 就指出,在沒有網路的環境下訓練模型會非常困難,而且會拖慢進度。越接近真實世界的訓練環境,模型越有用,也越可能在過程中碰到真實世界的系統。
另一個值得追蹤的是揭露機制。Transluce 的 Conrad Stosz 認為 Anthropic 主動揭露是好事,但主張需要獨立的第三方驗證,而不是依賴研究者自己發現、或公司自己報告。目前這些事件會被外界知道,幾乎都是因為公司選擇公布或媒體查到。Brad Smith 提的強制事故通報、英國要修的通報條文,都是在補這一塊。
對照之下,Nadella 那句「假設模型已經被入侵」聽起來很強烈,放回資安的脈絡卻是相當保守的立場:它不預設模型有敵意,只預設模型不可靠。對正在評估要把多少權限交給 AI 代理人的企業來說,這可能是目前最實用的一條心態調整——不是問「它會不會亂來」,而是問「它亂來的時候,我多久會知道、誰能把它關掉、事後查得出它做了什麼」。這三個問題在今天的多數導入案裡,答案都還是空白。
資料來源
- TechCrunch(2026/10/09):Anthropic can't reliably control its AI agents. It's cutting off its internal evals from the live internet instead
- TechCrunch(2026/10/10):Microsoft's Satya Nadella says AI models need an 'emergency brake'
- BetaNews(2026/10/12):Microsoft leaders call for emergency brakes on rogue AI
- TechCrunch(2026/09/29):OpenAI apologizes to Australia after its AI agents breached government sites